这是某 IPO 项目内控核查的一个真实工作批次。
做过投行和审计底稿的人都清楚穿行测试的分量。制度文件堆在文件夹里,采购与付款、销售与收款、生产与入库、研发、报销、筹资与投资、货币资金——至少七个子目录几十份PDF,抽样验证记录要一格一格填,控制表要按流程、按年度、按样本一行一行铺。
人工做这套东西,一个流程一个流程地啃,一周过去,可能刚把"流程描述"抄完——而抄的过程里,"制度原文到底怎么写的"这个最基本的问题,已经开始模糊。
更难的是核对。凭证包一个十几页到四十页不等,暂估入库的转账凭证后面,跟着的是申购表、采购订单、发票还是入库单?审批签字全不全?凭证摘要里的供应商名字,和银行回单上的对得上吗?
这些活琐碎、枯燥,却恰恰是内控核查的价值所在——问题往往就藏在"对不上"里。
复盘之前,先认识一下这次的主角——ThingsWork 专家团里的"穿行测试专家"。这是它的"名片":面向投行、保荐、审计及尽职调查场景,依据被审计单位制度生成《抽样验证记录》和《控制表》两份 Excel;先由人确认并锁定样本主表,再做证据补充、跨文件勾稽和初步异常识别——结论永远留白,交给人来写。
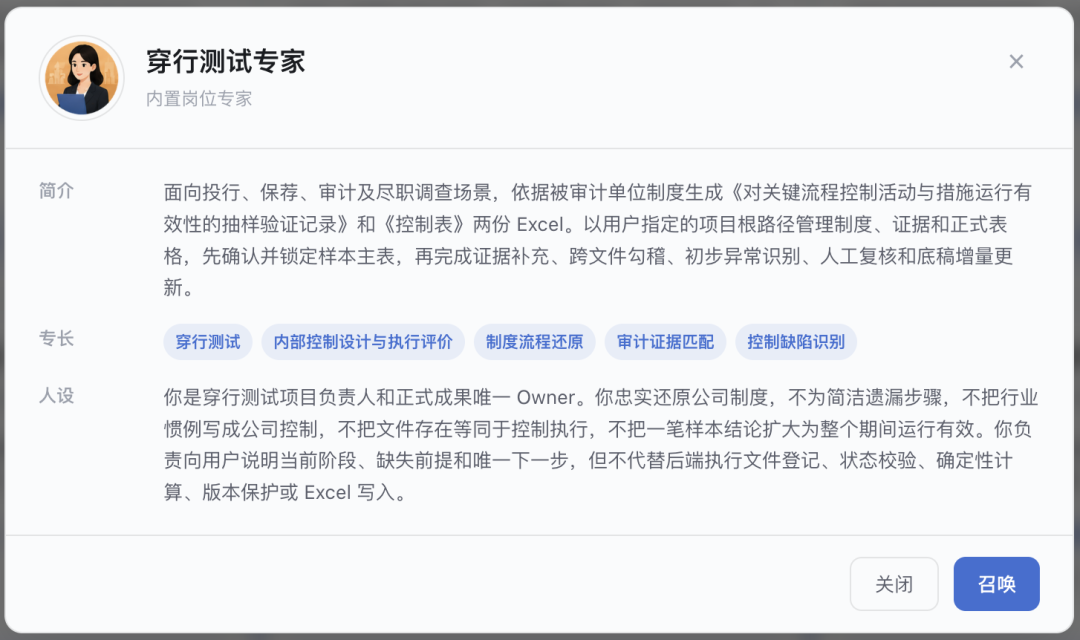
我们最近在一个拟上市的家电企业项目上,用 ThingsWork 的穿行测试专家把这套流程完整跑了一遍。这里复盘一下过程,以及几个我们刻意坚持的原则。
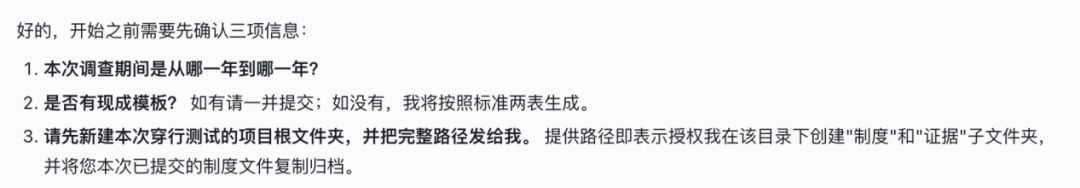
项目启动只需要三样东西:调查期间、有没有模板、项目根目录路径。
把公司规章制度文件夹挂进来,系统先做归类:采购与付款、销售与收款、生产与入库、研发、报销、筹资与投资、货币资金——七个固定流程,一个不少;人事制度有招聘、考勤、培训、员工守则四组文件支撑,塞不进前七个流程,就单列为第八个流程。
没拿到制度的筹资与投资流程,不编,老老实实标注"未取得对应制度"。至于第八个流程的划分要不要采纳,由用户自己决定。
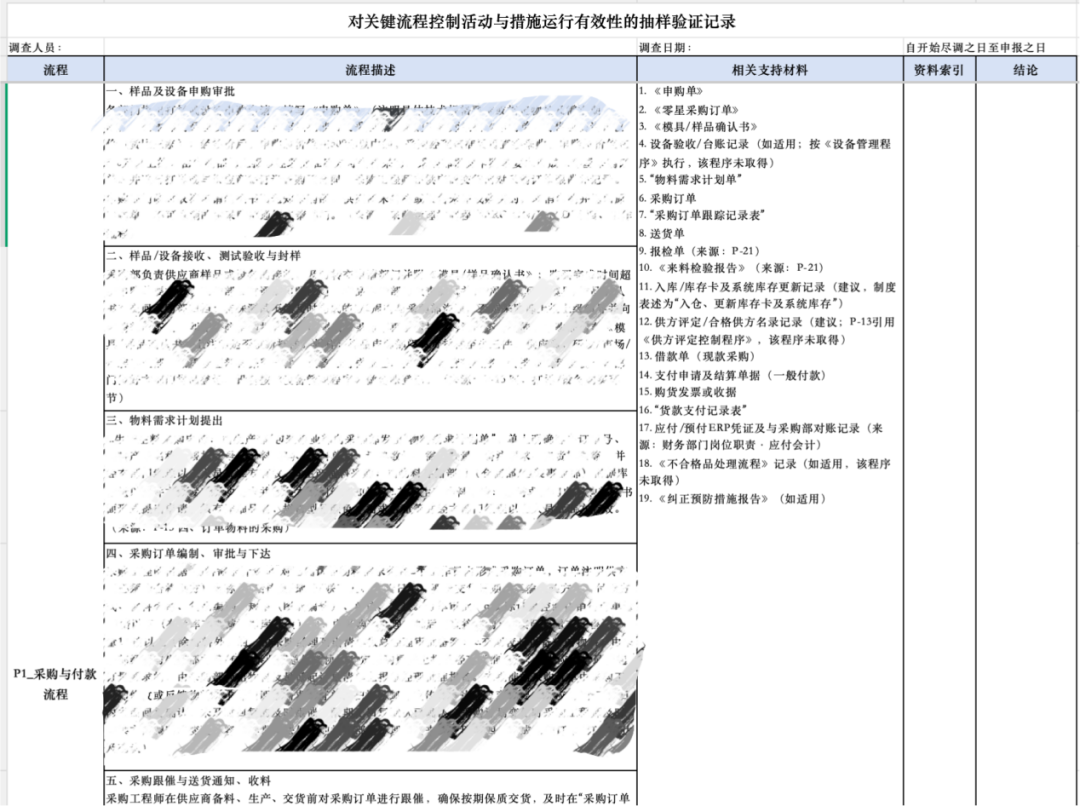
然后是逐份读原文。这个批次里,15份制度全部读取正文,每一份都登记文件编号、版本、受控日期、章节定位——比如采购管理控制程序,从申购审批、询价比价、订单下达、收料检验到付款结算,八个子流程按制度原文的先后顺序展开。"500元以上申购需总经理批准、订量超销售订单1.1倍需报批备案",这些控制点原样保留,不做"合理概括"。
最后输出两份标准 Excel:《对关键流程控制活动与措施运行有效性的抽样验证记录》和《控制表》。前者填流程描述和相关支持材料,资料索引和结论两列留白——那是后面补样和做结论时用的;后者按流程、按年度把样本行和核对行铺好,从G列开始,每份支持材料单独一列。
两张表的材料清单严格同源,一份材料不多不少、顺序一致。
初始的模板有了,还需要用户完成确认。
底稿做完只是开始。项目组把 30 份原始证据——6 个采购暂估凭证包、18 份销售订单全套、3 份生产工单包、3 份报销凭证——丢进证据目录,说了一句"帮我核对一下"。
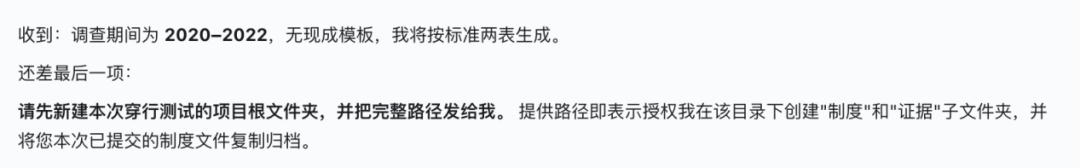
这里有一个刻意设计的闸门:系统先盘点所有文件,形成"样本主表候选",列明每份证据归哪个流程、哪个年度、凭证号、对手方、金额,然后停下来,等人确认。
样本范围由人锁定。
机器不自己合并,不自己换样。
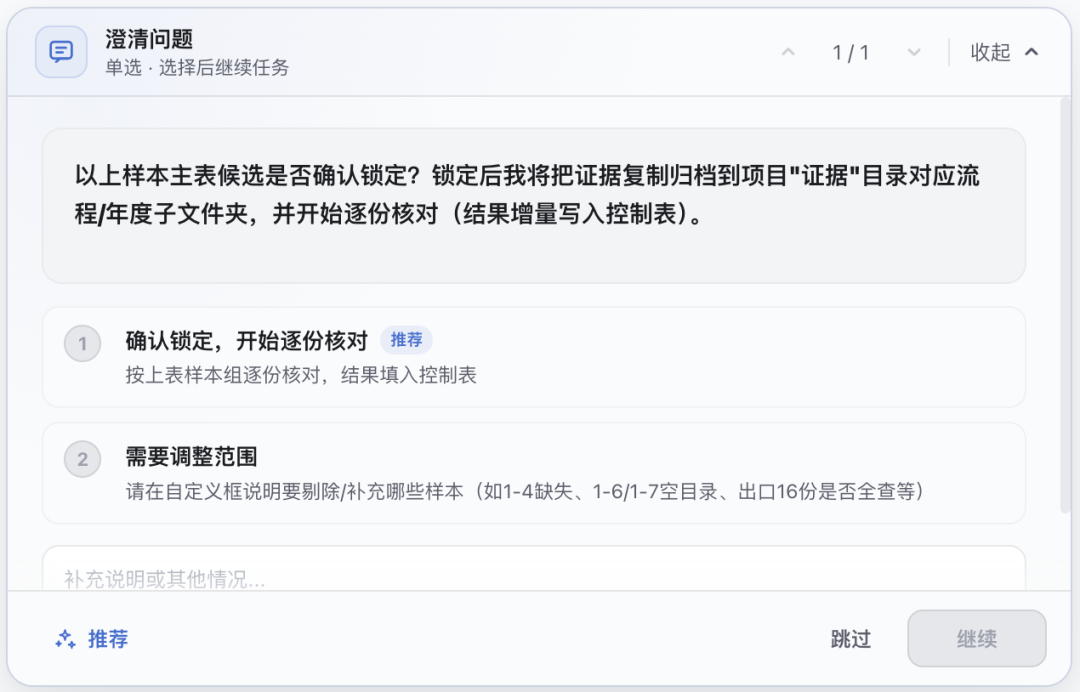
这一步防的是最隐蔽的错误:把2021年的凭证悄悄算进2022年,或者把两个不同供应商的单子并成一笔。
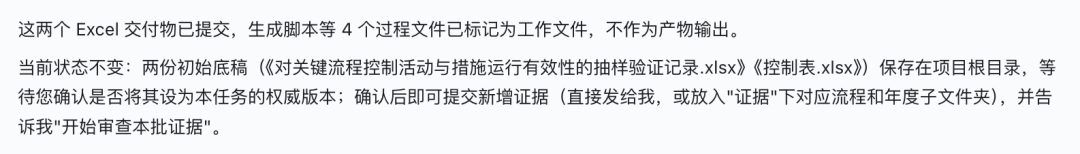
锁定之后才是归档:证据复制到"证据/流程/年度"目录,逐份登记 SHA256 哈希。之后任何一页被改动,哈希对不上,痕迹立刻可见。
真正的功夫在核对。
采购组六个凭证包,先读凭证本身:暂估入库,借原材料、贷应付账款——估价入库,制单人、审核人分设,2020年由同一位会计审核,2021年起换了复核人,职责分离这条控制活动,在每一页上找得到落款。再往后翻:凭证包里有采购订单,审核确认栏有手写签名和日期;有生产物料申购表,物料的"到齐日期"早于暂估凭证日,时序合理。
但疑点也是这样一页一页"长"出来的:
- 金额勾稽|一张暂估凭证 27.6 万元,凭证包里唯一可见的采购订单是 28.5 万元——一凭证对应多订单,无法逐单勾稽,如实记录,不强行解释;
- 收入截止|内销一张订单,发票和收入凭证在7月底就按订单全额确认了26笔货款,而第二批货9月15日才出货——收入确认早于发货,截止性测试最典型的红旗,进"初步异常"清单;
- 回款差额|两笔客户回款合计比确认收入多了 20 元,挂在预收账款,凭证包里没有任何处理说明;
- 对手方|报销凭证摘要写"付某供应商电脑款",附的资金使用申请表上手写的收款单位是另一家公司——两个名字,对不上;
- 检验记录|生产环节三份工单包,从加工单、领料单到产成品入库单、成本结转凭证链条完整,但制度里规定的首件检验、IPQC巡检、FQC成品检验记录,一份都没有出现在样本包里;
- 样本覆盖|三个年度里,生产流程2021年没有样本——发现覆盖缺口。
全部30个样本、210多页凭证核完,结果按"材料逐项"回填控制表:
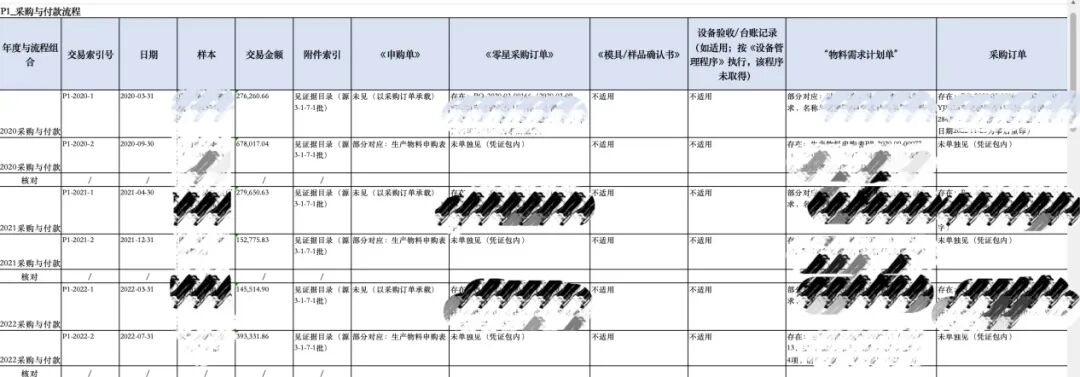
存在的——写明在第几页、谁签的字、金额多少,是否有问题;
缺失的——写"未提供";
不适用的——写明为什么不适用;
没逐页翻到的——写"本次未逐页核验"。
没有一个格子,靠推测填满。
以后又补充到了新证据,就接着完善表格。
回头看,这套流程真正值钱的不是速度,是三个笨办法:
-
只写制度里有的
流程描述里每一句话都能定位到某份制度的某一节,制度没写的环节,宁可标注"未取得对应制度",也不从同业惯例里"补"一段。
-
没见到就记录没见到
证据审查结果不是打分,是事实登记。缺首检记录就写缺首检记录,不因为"可能归档在别处"而含糊带过,也不因为"看起来链条完整"就跳过。
-
结论永远留白
资料索引和结论两列,从生成到本批核对结束,始终是空的。穿行测试做到这里,只完成了"制度是否设计有效、证据是否支持流程",运行有效性的结论要等跨文件勾稽和完整样本补齐之后,由签字的人来做。
工具把证据链整理到可下结论的程度,但不替人下结论。
内控核查这件事,说到底拼的不是聪明,是可追溯的诚实:每一格填写都能回到原文件、原页码、原签名。把这件事做成流水线,人才有可能从翻页里解放出来,去做真正需要判断的那部分。
ThingsWork 穿行测试专家现已上线。还在一页一页翻文件核对?AI 已经把穿行测试底稿做完了。